 1347
Чому той самий чатбот в одному випадку відповідає доречно, а в іншому може видати небажану інформацію? Двоє фізиків з Університету Джорджа Вашингтона запропонували математичний підхід, який має допомогти помітити небезпечний зсув у поведінці мовних моделей ще до появи проблемної відповіді.
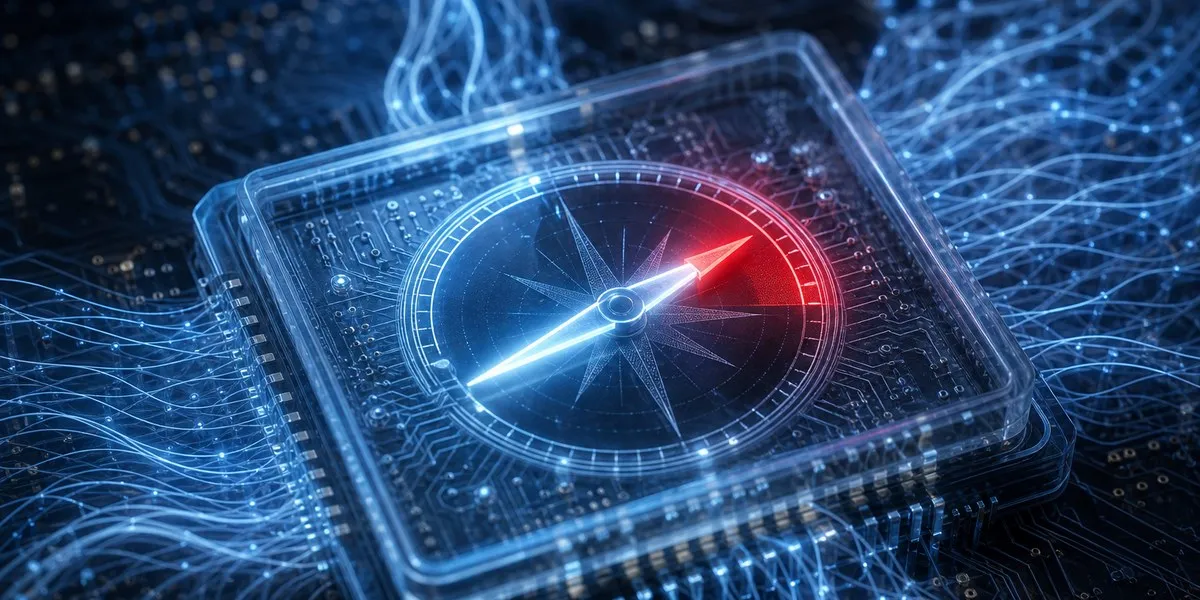
Ніл Джонсон і Френк Їндзє Хуо звернули увагу на внутрішні сигнали нейромережі під час обробки послідовності запитань. Вони порівняли один із таких сигналів — залишковий вектор — зі стрілкою компаса. На думку авторів, зміна його напряму може бути пов’язана з переходом від прийнятних відповідей до тих, які викликають занепокоєння.
На практиці вирішальним виявився не тільки зміст запиту, а й порядок попередніх реплік. В експериментах дослідники змінювали послідовність запитань про різні чутливі теми та стежили за реакцією GPT-2. У деяких сценаріях однакове запитання, поставлене на початку або наприкінці серії, супроводжувалося різною поведінкою моделі.
Спираючись на спостереження, фізики вивели формулу для оцінки моменту, коли внутрішній стан системи наближається до небажаного результату. Вони розглядають її як можливу систему раннього попередження. Досліди проводили в лабораторних умовах на відкритих моделях, зокрема GPT-2, Pythia й OPT.
Водночас далеко не всі фахівці переконані, що цього достатньо для прогнозування роботи сучасних асистентів. Дослідник Шеффілдського університету Вей Сін зауважив, що реальні мовні моделі значно складніші, ніж один математичний показник. Крім того, підхід не враховує всіх механізмів навчання безпечній поведінці, які застосовують у нинішніх системах.
Автори визнають необхідність подальших перевірок, хоча й вважають, що основні принципи будови досліджених моделей мають спільні риси з потужнішими системами. Отже, формула наразі залишається експериментальним інструментом для вивчення поведінки ШІ, а не доведеним універсальним захистом від усіх небезпечних відповідей.